
之前提過「為什麼意圖分析要分兩階段」:便宜的小模型先擋在前面做快篩,真的沒把握的案例才交給 LLM 精篩,這樣對地端服務來說既省 Token 又保住準確度。這篇就是把這個設計落成程式碼之後的樣子,照著「先看程式碼、再看說明」的順序,一段一段拆給你看。
project/
├── module/
│   └── IntentAnalysisLLM.py                  # 意圖分析模組本體
└── run-intent-analysis-example-fintuned.py   # 測試腳本
module/IntentAnalysisLLM.py:意圖分析模組本體,也就是那條「輸入 → 判斷 → 決策 → 交棒」流水線的實作。核心是一個用 LangGraph 組出來的狀態機,對外只透過 IntentAnalysisEngine 這個類別開一個窗口。
run-intent-analysis-example-fintuned.py:測試腳本,從專案根目錄用 from module.IntentAnalysisLLM import IntentAnalysisEngine 匯入模組,拿六十句測試問句去跑,順便算出準確率跟處理時間。
IntentAnalysisStateclass IntentAnalysisState(TypedDict):
"""意圖分析狀態管理"""
user_message: str
conversation_history: Optional[List[Dict]]
stage1_result: Optional[Dict]
stage2_result: Optional[Dict]
final_result: Optional[Dict]
final_classification: Optional[str]
final_confidence: Optional[float]
processing_path: List[str]
needs_stage2: bool
needs_stage3: bool
needs_validation: bool
這就是整個流程要傳來傳去的「狀態」。用 LangGraph 寫過流程的人應該很熟悉:每個節點吃進這包狀態、處理完再吐出更新後的狀態,一路傳到底。這裡特別想提兩個欄位:
processing_path:每經過一個節點就往裡面 append 一筆記錄,最後會拿到像 ["stage1", "stage2", "validation"] 這樣的路徑。上一篇提到「記錄每次的判斷路徑」是實作重點之一,這行就是那個重點的具體做法——之後想拿這批資料回頭優化小模型,這欄位就是現成的訓練素材。
needs_stage2 / needs_stage3:這是流程要不要升級的旗標,接下來的段落會看到它怎麼被設定。
### intent-classifier ###
intent_classifier = ChatOllama(
    base_url=config.get('ollama', 'BASE_URL'),
    model=config.get('ollama', 'MODEL-INTENT-CLASSIFIER'),
    temperature=0,
    num_gpu=100,
    num_ctx=4096
)


# ==================== Stage 1:快速預分類 ====================
def stage1_quick_classification(state: IntentAnalysisState) -> IntentAnalysisState:
    analyzer = OptimizedIntentAnalyzer()
    user_message = state["user_message"]

    try:
        response = intent_classifier.invoke(user_message)
        quick_result = parse_json_response(response)

        classification_value = quick_result.get('classification', 'C')
        confidence_data = quick_result.get('confidence')
        confidence = confidence_data[classification_value] if isinstance(confidence_data, dict) else 0.0

        # 例外規則一:B 類信心度不足,直接降級為 C
        if classification_value in ['B'] and confidence <= float(config.get('intent_analysis', 'THRESHOLDS-STAGE1-2')):
            classification_value = 'C'

        # 例外規則二:A/C 類信心度不足,強制升級到 Stage 2
        if classification_value in ['A', 'C'] and confidence <= float(config.get('intent_analysis', 'THRESHOLDS-STAGE1-2')):
            state["needs_stage2"] = True

        result = {"classification": classification_value, "confidence": confidence, "method": "intent-classifier"}
    except Exception:
        quick_result = None

    # intent_classifier 掛掉時的備援:換一支模型 + 完整規則 prompt 重新分類
    if not quick_result:
        response = analyzer.llm.invoke(prompt)  # prompt 內容為完整的 A/B/C 分類規則
        result = parse_json_response(response)

    state["stage1_result"] = result
    state["processing_path"].append("stage1")

    confidence = result.get("confidence", 0.0)
    if not state["needs_stage2"]:
        state["needs_stage2"] = confidence < analyzer.confidence_thresholds["stage1_high"]

    return state
Stage 1 對應的是意圖分析的Intent-Classifier(自訓練小模型),拿到結果後會做幾件事:
把 classification 跟對應的 confidence 抓出來(注意這裡的 confidence 是一個字典,用分類結果當 key 去取值,代表模型其實是把每個類別各給一個信心度,不是只吐一個數字)。
例外規則一:如果分到 B 但信心度低於門檻(THRESHOLDS-STAGE1-2),直接改判成 C。
例外規則二:如果分到 A 或 C,但信心度一樣低於這個門檻,就標記 needs_stage2 = True,逼它一定要升級。
這兩條例外蠻值得注意的 — 上一篇說「信心度門檻決定要不要升級」,聽起來像一條線那麼簡單,但實際落地的時候,不同類別其實需要不同的處理方式。B 類(推薦類問題)信心度低就直接降級成 C,而不是送去 LLM 重判,這是一種「與其花錢問 LLM,不如先假設它比較可能是查不到的雜項」的取捨。
走完 Stage 1,最後會根據信心度跟門檻決定要不要進 Stage 2:如果前面例外規則已經把 needs_stage2 設成 True,這裡就不覆蓋;否則就照最基本的邏輯 — 信心度不夠高就升級。
# ==================== Stage 2:精確分類 ====================
def stage2_precise_classification(state: IntentAnalysisState) -> IntentAnalysisState:
    analyzer = OptimizedIntentAnalyzer()

    # prompt 同樣列出 A/B/C 規則,多要求輸出 reasoning
    # 輸出格式:{"classification": "A/B/C", "confidence": 0.0-1.0, "reasoning": "簡短理由"}
    response = analyzer.llm.invoke(prompt)
    result = parse_json_response(response)

    state["stage2_result"] = result
    state["processing_path"].append("stage2")
    state["needs_validation"] = True

    confidence = result.get("confidence", 0.0)
    state["needs_stage3"] = confidence < analyzer.confidence_thresholds["stage2_accept"]

    return state
只有真的沒把握的案例才會走到這裡,所以可以放心用比較貴、比較慢的完整 LLM 分析。這一階段的 prompt 比 Stage 1 的備援 prompt 又更細一點,多了幾個東西:
reasoning 欄位,讓分類結果多一份可解釋性。final_validation# ==================== 結果驗證 ====================
def final_validation(state: IntentAnalysisState) -> IntentAnalysisState:
results = [r for r in [state.get('stage2_result'), state.get('stage1_result')] if r and r.get('classification')]
if not results:
final_result = {"final_classification": "A", "final_confidence": 0.5, "validation_passed": False}
else:
best_result = max(results, key=lambda x: x.get('confidence', 0))
classifications = [r.get('classification') for r in results]
most_common = max(set(classifications), key=classifications.count)
consistency = classifications.count(most_common) / len(classifications)
final_result = {
"final_classification": best_result.get('classification'),
"final_confidence": min(best_result.get('confidence', 0.5) * consistency, 1.0),
"validation_passed": consistency >= 0.5,
"consistency_score": consistency
}
state["final_result"] = final_result
state["processing_path"].append("validation")
state["final_classification"] = final_result.get("final_classification")
state["final_confidence"] = final_result.get("final_confidence")
return state
上一篇文章裡把「比對統整」描述成系統邏輯:兩階段都有結果時,通常以第二階段為準,或是「不一致就標記低信心」。實際寫出來更細一點,是用一致性(consistency)去加權信心度,而不是單純選最後一個結果:
先把所有階段跑出來的結果收集起來(如果只有 Stage 1,就只有一筆;升級過就有兩筆)。
分類結果用「信心度最高的那個」當最終分類。
但最終信心度不是直接沿用那個最高值,而是拿它乘上「一致性分數」— 也就是兩階段判斷有沒有吵架。如果 Stage 1 跟 Stage 2 給出同樣的分類,一致性是 1,信心度不打折;如果兩邊各說各話,一致性掉到某個比例,最終信心度也跟著被拉低。
這樣設計的用意很直覺:兩個模型都同意,才真的敢有把握。就算某一階段自己講信心度 0.9,只要另一階段唱反調,系統也不會照單全收。這其實比單純「以後面階段為準」更保守、也更適合拿 validation_passed 這個欄位去做後續的人工複核觸發條件。
# ==================== LangGraph 工作流程 ====================
def create_intent_analysis_graph():
    workflow = StateGraph(IntentAnalysisState)

    workflow.add_node("stage1", stage1_quick_classification)
    workflow.add_node("stage2", stage2_precise_classification)
    workflow.add_node("validation", final_validation)
    workflow.set_entry_point("stage1")

    workflow.add_conditional_edges(
        "stage1", should_continue_to_stage2,
        {"stage2": "stage2", "validation": "validation"}
    )
    workflow.add_conditional_edges("stage2", lambda x: "validation", {"validation": "validation"})
    workflow.add_conditional_edges("validation", validation_router, {END: END})

    return workflow.compile()


class IntentAnalysisEngine:
    """意圖分析引擎"""
    def __init__(self):
        self.graph = create_intent_analysis_graph()

    def analyze(self, user_message: str, conversation_history: Optional[List[Dict]] = None) -> Dict:
        initial_state = IntentAnalysisState(
            user_message=user_message,
            conversation_history=conversation_history or [],
            stage1_result=None, stage2_result=None,
            final_classification=None, final_confidence=None,
            processing_path=[], needs_stage2=False, needs_stage3=False, needs_validation=False
        )
        final_state = self.graph.invoke(initial_state)

        return {
            "classification": final_state.get("final_classification"),
            "confidence": final_state.get("final_confidence"),
            "processing_path": final_state.get("processing_path", []),
        }
前面幾個函式都準備好了,這裡就是把它們接成流程。路徑其實只有兩條:
跟上一篇的架構圖完全對得上 —「信心度門檻」在這裡就是 should_continue_to_stage2 這個路由函式,單純看 state["needs_stage2"] 是 True 還是 False 來決定走哪條路。
最外層包一個 IntentAnalysisEngine 當作對外唯一窗口,呼叫端只需要呼叫 .analyze(user_message),不用管內部的節點細節。
from module.IntentAnalysisLLM import IntentAnalysisEngine

engine = IntentAnalysisEngine()

test_cases = [
    "這台主機支援哪些 Intel 處理器型號?",
    "有哪些機型適合影像編輯工作?",
    "無風扇設計的主機有什麼優缺點?",
    # ...(中文 30 句 + 對應英文 30 句,共 60 句)
    "Which Intel processor models does this desktop support?",
    "Which models are suitable for video editing work?",
    # ...
]

test_answers = [
    "A",  # Q1 - 處理器支援查詢
    "B",  # Q2 - 應用情境建議
    "C",  # Q3 - 結構優劣討論
    # ...(依序對應每一句測試問句)
]

correct_count, wrong_count, total_count = 0, 0, 0

for i, message in enumerate(test_cases, 1):
    result = engine.analyze(message)
    classification = result.get('classification', 'C')

    if classification == test_answers[i-1]:
        correct_count += 1
    elif test_answers[i-1] in ['A', 'C'] and classification in ['A', 'C']:
        correct_count += 1  # A/C 視為同類
    else:
        wrong_count += 1

    total_count += 1

print(f"📊 正確率:{(correct_count/total_count)*100:.2f}%")
測試腳本的工作很單純:準備好一批「已知正確答案」的測試問句,把它們一句一句丟進 IntentAnalysisEngine,看分類結果對不對、花多久。測試案例有三十句中文,加上完全對應的三十句英文翻譯,搭配一份對照的正確答案陣列 test_answers,每題都用註解寫清楚是哪一類問題(處理器支援查詢、應用情境建議……),方便之後回頭核對。
跑分的邏輯裡有一個很值得注意的細節:如果正確答案是 A 或 C,而模型分出來的也是 A 或 C(哪怕兩者不完全一樣),照樣算對。這反映了一個實務上很常見的狀況:A(產品資訊查詢)跟 C(其他)這兩類的邊界,本來就比 A/B 之間模糊很多,一句話到底算不算是「產品規格」相關,很多時候連人工標註都會有分歧,更別說要求模型精準切開。與其死摳這個模糊地帶,不如放寬判分規則,把精力留給真正有清楚界線的 A/B 分類品質上。這是一個「測試設計要貼合業務容忍度」的好例子。
最後輸出的是總處理時間、平均每案例時間,還有正確率——這三個數字合在一起看,才看得出「兩階段設計」到底有沒有省到成本:如果大部分案例都走短路徑(只有 Stage 1),平均時間應該會壓得很低,只有少數案例因為升級到 Stage 2 才會把平均值往上拉一點。
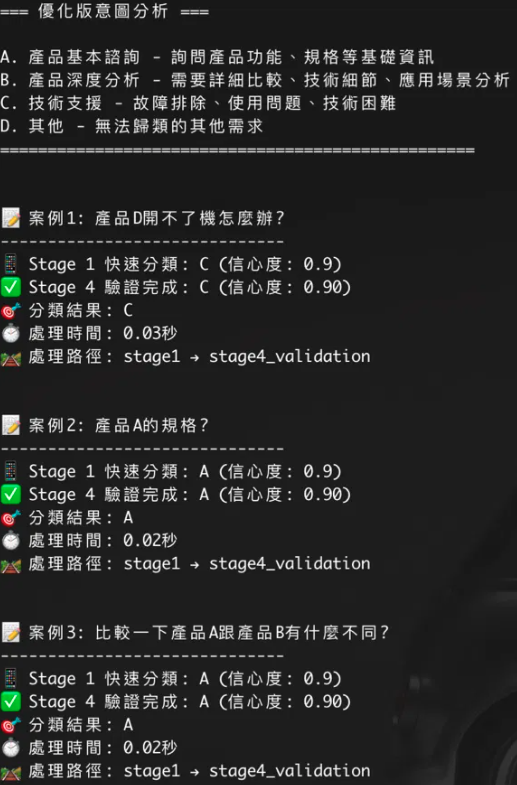
大部分案例都是「一步到位」,處理時間幾乎都在 0.02~0.03 秒內結束,這就是兩階段設計真正省 Token 的地方——大多數清楚明確的問句,小模型自己就能搞定,完全不需要動用到 LLM。但也有需要走完整條路的案例。案例 11「閒聊一下,今天的天氣如何?」就是個好例子:
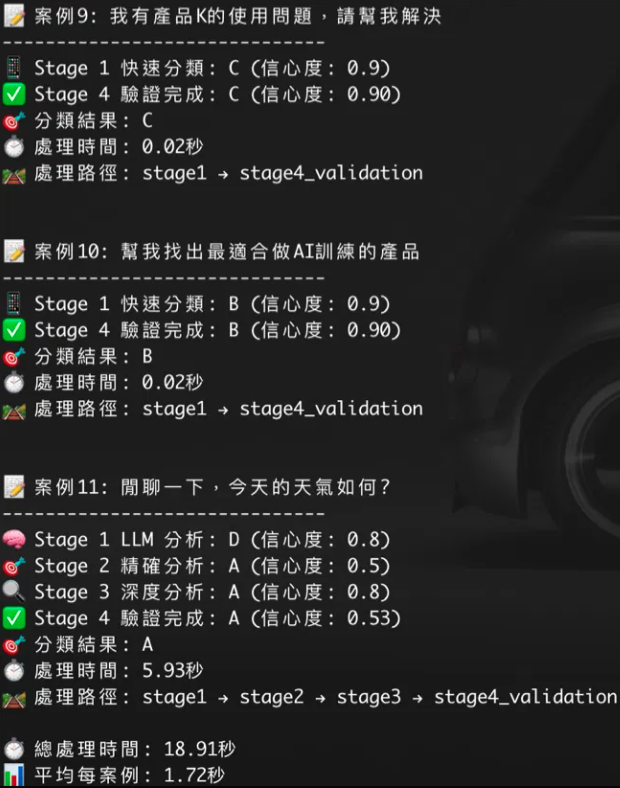
這句話本來就不是產品相關的問題,小模型第一輪判斷信心度不夠(甚至一開始還分到一個不存在的 D 類),於是一路往下升級,直到最後一階段驗證才收斂到 A。處理時間也從其他案例的 0.02 秒,一口氣拉到 5.93 秒 — 這正是「把珍貴的 LLM 資源留給真正模糊的問題」這句話的具體樣子:清楚的問題幾毫秒解決,真正搞不清楚的問題才會花比較多時間跟成本去確認。


 iThome鐵人賽
 看影片追技術